让 AI 规划、编写并修复你的 Playwright 测试,同时不让它掩盖真实缺陷。本课程包含人工智能的使用。
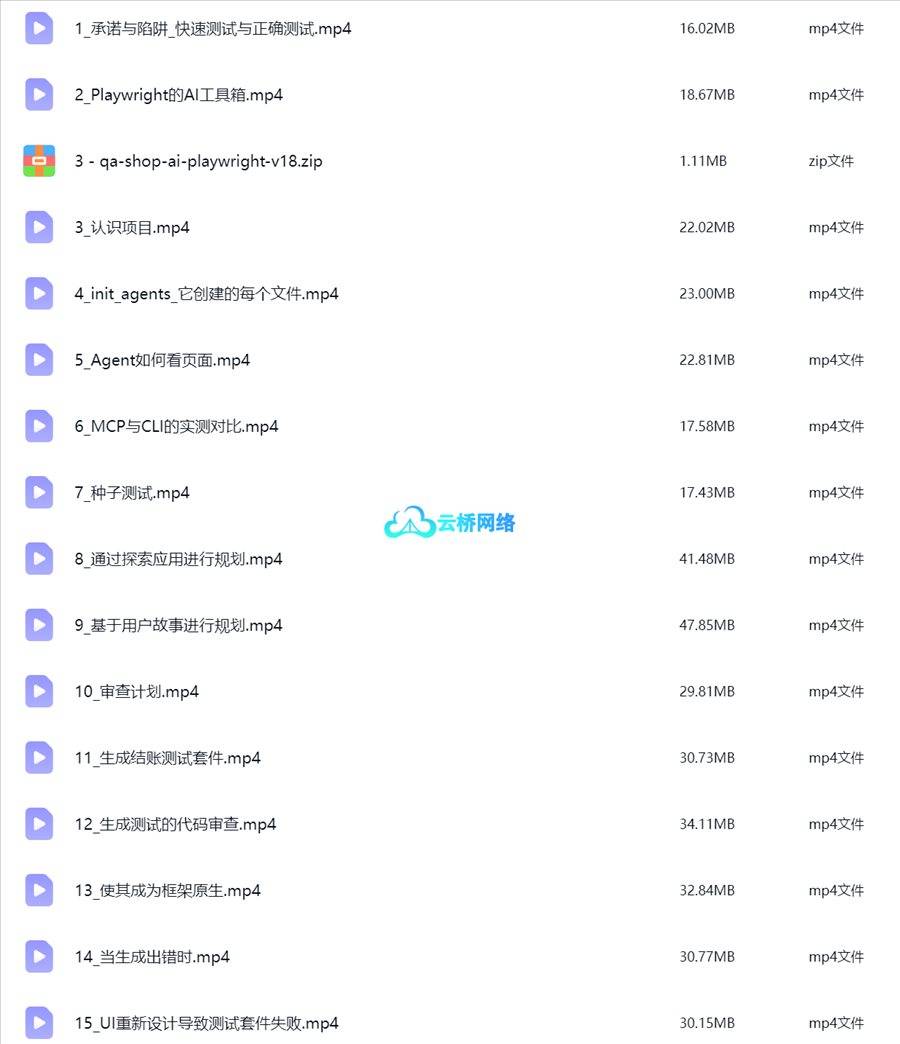
AI 可以快速生成 Playwright 测试,但速度并不等同于可信赖的自动化。本课程向 QA 工程师和测试自动化团队展示如何使用 AI 代理来规划、生成、审查、修复和衡量 Playwright 测试,同时让人类掌控测试意图。
你将使用 Playwright Test Agents、Claude Code、Playwright MCP、playwright-cli 技能、可访问性快照、fixture、页面对象、追踪、GitHub Actions 和实用防护栏。你不会把生成的代码视为自动正确,而是学习如何审查 AI 计划中缺失的用例、虚构的行为、弱断言、脆弱的定位器、不必要的等待和框架违规。
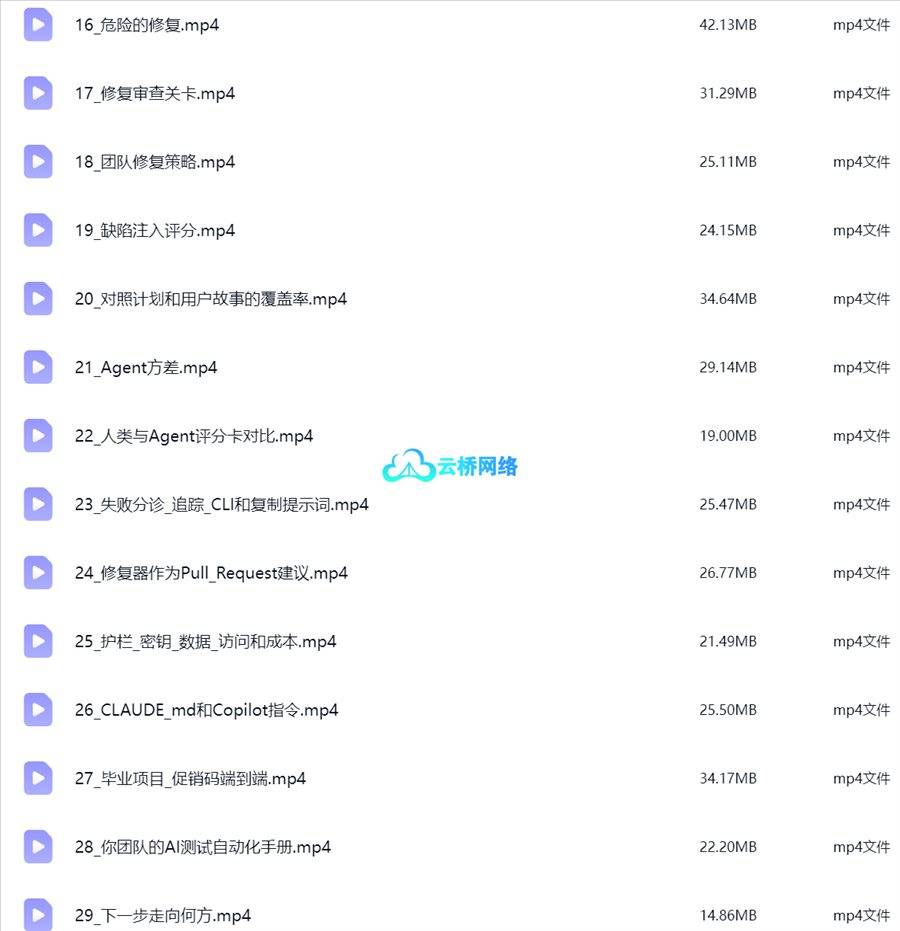
本课程包含一个完整的 QA Shop 项目,其中有检查点、提示词、参考运行、答案键、缺陷开关和可重复的代理场景。你将看到一个规划器把需求和应用程序探索转化为测试计划,一个生成器把该计划转换为框架原生的 TypeScript 测试,以及一个修复器修复 UI 变更。你还会看到修复的危险一面:断言更改、预期值编辑、跳过和 fixme 注解,这些都可能让流水线变绿,而真实缺陷仍然存在。
你将构建审查门禁,将安全的定位器和等待修复与需要人工批准的更改区分开来。你将使用缺陷注入评分、覆盖率、运行间方差以及人类对代理记分卡来衡量代理输出。最后几个部分将这些理念应用于故障分类、GitHub Actions、Claude 项目指令、Copilot 指导、密钥、生产数据边界、成本控制以及一个端到端的促销码 capstone。
到最后,你将拥有一本实用的 AI 测试自动化行动手册:代理可以负责打字,但你的团队仍然拥有需求、断言、发布决策和质量。
课程时长:3小时 1920X1080 mp4 语言:英语+Ai中英文字幕 含中文朗读版本
**你将学到什么**
– 根据需求和应用程序探索来规划 Playwright 测试覆盖范围,同时识别缺失的负面用例和虚构的行为。
– 生成框架原生的 Playwright 测试,包括可靠的定位器、断言、fixture、页面对象和一致性检查。
– 审查 AI 生成的计划、测试和修复补丁,使定位器修复能够通过,同时断言更改、跳过和隐藏缺陷被拦截。
– 使用缺陷注入评分、覆盖率、方差、追踪分析和受保护的 GitHub Actions 工作流来衡量 AI 测试质量。
**要求**
具备 Playwright 和 TypeScript 的工作知识;学习者应能够轻松阅读并运行自动化浏览器测试。
**本课程适合谁**
希望使用 AI 代理配合 Playwright,同时不牺牲测试意图或缺陷检测能力的 QA 工程师、测试自动化工程师、SDET 和 QA 负责人。
1、VIP会员仅需30元全站资源免费下载!
2、资源默认为百度网盘链接,请用浏览器打开输入提取码不要有多余空格,如无法获取 请联系微信 yunqiaonet 补发。
3、分卷压缩包资源 需全部下载后解压第一个压缩包即可,下载过程不要强制中断 建议用winrar解压或360解压缩软件解压!
4、云桥CG资源站所发布资源仅供用户自学自用,用户需以学习为目的,按需下载,严禁批量采集搬运共享资源等行为,望知悉!!!
5、云桥CG资源站,感谢您的赞赏与支持!平台所收取打赏费用仅作为平台服务器租赁及人员维护资金 费用不为素材本身费用,望理解知悉!平台资源仅供用户学习观摩使用 请下载24小时内自行删除 如需商用请支持原版作者!请知悉并遵守!
6、For international users: If you do not have a Baidu Netdisk VIP account, please contact WeChat: yunqiaonet for assistance with logging into Baidu Netdisk to download resources..